Introducción
Dos programas pueden resolver el mismo problema y, sin embargo, uno tardar un segundo y el otro tres años. Cuando los datos son pocos, la diferencia no se nota; cuando crecen, sí. La complejidad algorítmica es la herramienta que permite saber, antes de ejecutar un algoritmo, cómo crecerá su coste al aumentar el tamaño de los datos.
En este artículo aprenderás a contar operaciones, a leer y usar la notación O grande (Big O), a calcular la complejidad de un código sencillo y a comparar algoritmos con números reales. Si no has visto aún qué es un algoritmo, empieza por introducción a algoritmos y pseudocódigo, y para ver cómo influye la estructura elegida, consulta el artículo de estructuras de datos.
1. Medir sin cronómetro: contar operaciones
Medir el tiempo con un cronómetro depende del ordenador, del lenguaje y de lo que esté haciendo la máquina en ese momento. Para comparar algoritmos de forma justa se cuenta cuántas operaciones básicas (comparaciones, asignaciones, sumas) necesita, en función del tamaño de la entrada. Si el algoritmo recorre una lista de elementos haciendo una comparación en cada uno, hace unas operaciones; si recorre todos los pares de elementos, hace unas operaciones.
2. La notación O grande
La notación O describe cómo crece el número de operaciones cuando se hace muy grande, ignorando las constantes y los términos pequeños. Si un algoritmo hace operaciones, decimos que es , porque para grande el término domina sobre todo lo demás. Estas son las complejidades más habituales, de menor a mayor coste:
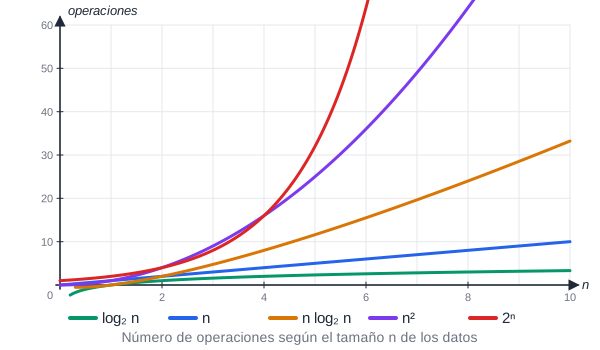
La exponencial supera a todas las demás con tamaños muy pequeños.
Con números concretos la diferencia es abismal. Estas son las operaciones que hace cada tipo de algoritmo para varios tamaños:
3. Cómo calcular la complejidad de un código
Con tres reglas se analiza la mayoría de los algoritmos sencillos:
- Cada instrucción simple (una asignación, una suma, una comparación) cuesta .
- Un bucle que se repite veces multiplica el coste de lo que hay dentro. Un bucle dentro de otro multiplica los dos: .
- El resultado final se simplifica: se quitan las constantes y se deja solo el término que más crece.
Ejemplo 1: máximo de una lista. El bucle recorre los elementos y hace una comparación en cada vuelta:
def maximo(lista):
    mayor = lista[0]                 # 1 operación
    for valor in lista:              # el bucle se repite n veces
        if valor > mayor:            # 1 comparación por vuelta
            mayor = valor
    return mayor
Coste: , que se simplifica a : lineal.
Ejemplo 2: ¿hay elementos repetidos? Se comparan todos los pares de posiciones. Aquí hay un bucle dentro de otro:
def hay_duplicados(lista):
    comparaciones = 0
    for i in range(len(lista)):
        for j in range(i + 1, len(lista)):    # bucle dentro de bucle
            comparaciones += 1
            if lista[i] == lista[j]:
                return True, comparaciones
    return False, comparaciones


print(hay_duplicados(list(range(10))))
print(hay_duplicados(list(range(100))))
Salida (con listas sin repetidos, es decir, el peor caso):
(False, 45)
(False, 4950)
Con 10 elementos se hacen 45 comparaciones y con 100 elementos, 4.950. En general son , que es del orden de : complejidad . Al multiplicar por 10 el tamaño, el trabajo se multiplica por unos 100.
4. Búsqueda lineal frente a búsqueda binaria
Buscar un valor en una lista tiene dos estrategias. La búsqueda lineal mira elemento a elemento: . La búsqueda binaria exige que la lista esté ordenada, compara con el elemento del medio y descarta la mitad en cada paso: . Contamos las comparaciones reales en el peor caso (buscar el último elemento):
def busqueda_lineal(lista, objetivo):
    comparaciones = 0
    for valor in lista:
        comparaciones += 1
        if valor == objetivo:
            break
    return comparaciones


def busqueda_binaria(lista, objetivo):
    bajo, alto = 0, len(lista) - 1
    comparaciones = 0
    while bajo <= alto:
        medio = (bajo + alto) // 2
        comparaciones += 1
        if lista[medio] == objetivo:
            break
        elif lista[medio] < objetivo:
            bajo = medio + 1
        else:
            alto = medio - 1
    return comparaciones


for n in (1_000, 1_000_000):
    datos = list(range(n))                      # lista ordenada
    print(n, busqueda_lineal(datos, n - 1), busqueda_binaria(datos, n - 1))
Salida (tamaño, comparaciones de la búsqueda lineal, comparaciones de la binaria):
1000 1000 10
1000000 1000000 20
Con un millón de elementos, la lineal necesita 1.000.000 de comparaciones y la binaria solo 20. La razón es que : cada comparación divide el problema a la mitad, y un millón se puede dividir por la mitad unas 20 veces antes de llegar a 1.
5. Ejemplo resuelto: ¿cuánto tarda de verdad?
Enunciado. Una máquina hace una operación por nanosegundo ( s). Calcula cuánto tarda un algoritmo de cada complejidad con de datos (y, para la exponencial, con solo ).
Solución. Se calcula el número de operaciones y se multiplica por segundos:
Un algoritmo cuadrático con un millón de datos ya tarda unos 17 minutos, y uno exponencial no termina en toda una vida con solo 60 elementos. Por eso en la práctica se evitan los algoritmos exponenciales y se busca bajar de a siempre que se puede: es la diferencia entre 17 minutos y 20 milisegundos.
6. Mejor caso, peor caso y caso medio
El coste puede variar según los datos. En la búsqueda lineal, si el valor está el primero, basta una comparación (mejor caso, ); si está el último o no está, hay que mirar todos (peor caso, ); en promedio se miran la mitad (caso medio, también ). Por defecto, cuando se habla de la complejidad de un algoritmo se refiere al peor caso, porque es la garantía que se puede ofrecer.
Además del tiempo existe la complejidad espacial: cuánta memoria adicional necesita. Un algoritmo puede ser muy rápido pero gastar mucha memoria, y a menudo hay que elegir entre ambas cosas.
7. Errores frecuentes
- ⚠️ Creer que O(n) significa «n operaciones exactas». O describe cómo crece el coste, no su valor exacto. Un algoritmo con operaciones y otro con son ambos
- ⚠️ Conservar constantes y términos pequeños. se escribe : al crecer , lo demás deja de importar
- ⚠️ Pensar que O(n²) siempre es peor que O(n). Solo para grande. Con pocos datos, un algoritmo con mejor complejidad pero más constantes puede ser más lento
- ⚠️ Usar búsqueda binaria en una lista sin ordenar. Solo funciona si los datos están ordenados; si no, hay que ordenarlos antes (coste ) o usar la lineal
- ⚠️ Olvidar que los bucles anidados multiplican. Dos bucles de vueltas anidados hacen operaciones, no
8. 📌 En 30 segundos
- La complejidad mide cómo crece el coste de un algoritmo con el tamaño de los datos, contando operaciones.
- La notación O ignora constantes y términos menores: es .
- De menor a mayor coste: , , , , , .
- Un bucle multiplica el coste de su interior; dos bucles anidados dan .
- La búsqueda binaria () necesita una lista ordenada y es mucho más rápida que la lineal ().