Introducción
Cada vez que inicias sesión en una web, compras algo en línea o ves tus mensajes en una red social, hay una base de datos detrás guardando y recuperando información. Pero no todas las bases de datos funcionan igual: las relacionales, basadas en tablas, llevan décadas siendo el estándar, y las no relacionales (NoSQL) han ganado terreno para problemas concretos.
En este artículo aprenderás cómo se organiza una base de datos relacional (tablas, claves primarias y foráneas), qué garantiza el modelo ACID, qué tipos de bases NoSQL existen y, sobre todo, cómo decidir cuál conviene en cada caso. Para consultar los datos con el lenguaje SQL, continúa después con el artículo de SQL básico.
1. Base de datos y sistema gestor
Una base de datos es un conjunto organizado de datos relacionados entre sí. El programa que la administra se llama sistema gestor de bases de datos (SGBD): PostgreSQL, MySQL, SQLite, Oracle, MongoDB o Redis son ejemplos. ¿Por qué no guardar todo en archivos sueltos? Porque un SGBD resuelve problemas difíciles: permite que muchos usuarios lean y escriban a la vez sin pisarse, evita datos incoherentes, ofrece un lenguaje para consultar y controla quién puede ver cada cosa.
2. El modelo relacional
En una base relacional los datos se guardan en tablas. Cada tabla tiene este aspecto:
- Cada columna (o atributo) es un dato con un tipo concreto: texto, número, fecha...
- Cada fila (o registro) es un elemento: un alumno, un pedido, un libro...
- La clave primaria (PK) es la columna (o conjunto de columnas) que identifica de forma única cada fila: nunca se repite ni es nula.
- La clave foránea (FK) es una columna que guarda la clave primaria de otra tabla y así las relaciona.
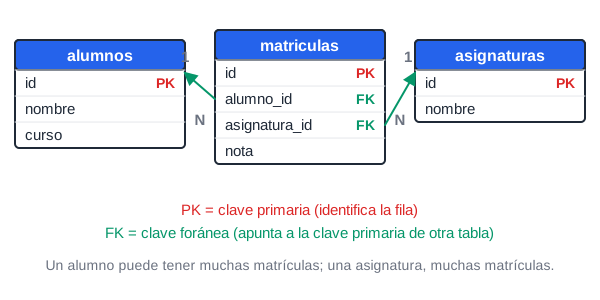
Las claves foráneas de la tabla matriculas apuntan a las claves primarias de alumnos y asignaturas.
Este diseño se escribe en SQL así (el código está comprobado y funciona en SQLite):
CREATE TABLE alumnos (
    id      INTEGER PRIMARY KEY,
    nombre  TEXT NOT NULL,
    curso   TEXT NOT NULL
);

CREATE TABLE asignaturas (
    id      INTEGER PRIMARY KEY,
    nombre  TEXT NOT NULL
);

CREATE TABLE matriculas (
    id             INTEGER PRIMARY KEY,
    alumno_id      INTEGER NOT NULL REFERENCES alumnos(id),
    asignatura_id  INTEGER NOT NULL REFERENCES asignaturas(id),
    nota           REAL
);
El SGBD impide, por integridad referencial, guardar una matrícula de un alumno que no existe. Esa es la ventaja de separar los datos en tablas en lugar de repetirlos: el nombre de cada alumno se guarda una sola vez y las matrículas solo guardan su id. Si el alumno cambia de nombre, se corrige en un único sitio. Este principio de no duplicar datos se llama normalización.
3. Transacciones y propiedades ACID
Imagina una transferencia bancaria de 100 € entre dos cuentas: hay que restar de una y sumar en otra. Si el sistema falla justo en medio, no puede quedar el dinero «desaparecido». Una transacción agrupa varias operaciones para que se ejecuten todas o ninguna. Las bases relacionales garantizan cuatro propiedades, conocidas como ACID:
- Atomicidad: la transacción se completa entera o no se hace nada.
- Consistencia: la base pasa de un estado válido a otro válido, respetando todas las reglas (claves, restricciones).
- Aislamiento (isolation): varias transacciones simultáneas no se estorban; cada una actúa como si estuviera sola.
- Durabilidad: una vez confirmada, la transacción no se pierde aunque el sistema se apague.
4. Bases de datos no relacionales (NoSQL)
«NoSQL» significa, más que «sin SQL», «no solo SQL»: agrupa bases que no usan tablas con relaciones rígidas. Surgieron para manejar enormes volúmenes de datos distribuidos en muchos servidores y datos con estructura variable. Hay cuatro familias principales:
Así se vería un producto en una base de documentos. Observa que lleva listas y objetos anidados, algo que en tablas requeriría varias de ellas:
{
  "_id": "p-1042",
  "nombre": "Camiseta técnica",
  "precio": 24.9,
  "tallas": ["S", "M", "L"],
  "material": { "tejido": "poliéster reciclado", "lavado": "30 ºC" },
  "etiquetas": ["running", "verano"]
}
Muchos sistemas NoSQL distribuidos relajan la consistencia inmediata a cambio de más disponibilidad y facilidad para crecer añadiendo servidores; esto se conoce como consistencia eventual: los datos acaban siendo iguales en todos los nodos, pero no necesariamente en el mismo instante.
5. Comparación
6. Ejemplos resueltos
Ejemplo 1. Elige el tipo de base de datos más adecuado para cada caso y justifícalo.
- Un banco con cuentas y movimientos. Relacional: necesita transacciones ACID estrictas y relaciones claras entre clientes, cuentas y movimientos.
- Un catálogo de productos donde cada uno tiene atributos distintos (una camiseta tiene talla; un portátil, procesador y RAM). Documentos: cada producto es un documento con su propia estructura, sin columnas vacías.
- Una red social que pregunta «¿qué amigos tenemos en común?». Grafos: las relaciones entre personas son el dato principal y se recorren muy rápido.
- Guardar la sesión de cada usuario conectado durante 30 minutos. Clave-valor: se accede por una clave (el identificador de sesión), hay que leer y escribir muy rápido y los datos son temporales.
- Una academia con alumnos, grupos, clases y pagos. Relacional: son datos muy estructurados y con muchas relaciones que deben mantenerse coherentes.
Ejemplo 2. Diseña las tablas de una biblioteca que registra libros, socios y préstamos.
Un socio puede tener muchos préstamos y un libro puede prestarse muchas veces, pero cada préstamo es de un libro y un socio concretos. Por eso prestamos lleva dos claves foráneas y es la tabla que relaciona las otras dos:
CREATE TABLE libros (
    id      INTEGER PRIMARY KEY,
    titulo  TEXT NOT NULL,
    autor   TEXT NOT NULL
);

CREATE TABLE socios (
    id      INTEGER PRIMARY KEY,
    nombre  TEXT NOT NULL,
    email   TEXT UNIQUE
);

CREATE TABLE prestamos (
    id              INTEGER PRIMARY KEY,
    libro_id        INTEGER NOT NULL REFERENCES libros(id),
    socio_id        INTEGER NOT NULL REFERENCES socios(id),
    fecha_prestamo  TEXT NOT NULL,
    fecha_devolucion TEXT
);
La columna fecha_devolucion puede quedar vacía (NULL) mientras el libro no se haya devuelto.
7. Errores frecuentes
- ⚠️ Pensar que NoSQL es «mejor» o siempre más rápido. Depende del problema. Para datos muy relacionados que exigen integridad, una base relacional suele ser la mejor opción.
- ⚠️ Confundir base de datos con SGBD. La base de datos son los datos; el SGBD (PostgreSQL, MongoDB...) es el programa que los gestiona.
- ⚠️ Duplicar datos en lugar de relacionar tablas. Si el nombre del alumno se repite en cada matrícula, un cambio obliga a corregirlo en muchos sitios y es fácil dejar datos incoherentes.
- ⚠️ Diseñar tablas sin clave primaria. Sin una columna que identifique cada fila no se puede relacionar la tabla de forma fiable.
- ⚠️ Creer que «sin esquema» significa «sin estructura». Una base de documentos admite estructuras flexibles, pero la aplicación sigue necesitando saber qué campos espera.
8. 📌 En 30 segundos
- Una base relacional guarda datos en tablas; la clave primaria identifica cada fila y la clave foránea relaciona tablas.
- Las transacciones ACID (atomicidad, consistencia, aislamiento, durabilidad) garantizan que los datos no queden a medias.
- NoSQL agrupa bases de documentos, clave-valor, columnas anchas y grafos; ofrecen esquema flexible y escalado horizontal.
- Relacional: datos estructurados y muy relacionados con integridad. NoSQL: datos variables, enormes o de acceso muy rápido.
- No hay una opción mejor en abstracto: se elige según los datos y las consultas que tendrá la aplicación.